Análisis de una encuesta de clima laboral con ponderadores y errores estándar según el diseño
Estimación ponderada, efecto de diseño y errores estándar por linealización en una muestra estratificada por conglomerados.
Análisis de encuestas
Ponderación
Python
Fecha de publicación
22 de octubre de 2026
El problema
Una empresa de servicios con 60 sucursales, 45 en el interior y 15 en la capital, encarga una encuesta de clima laboral. Por razones de costo no se visitan todas las sucursales: se eligen al azar 8 del interior y 6 de la capital, y en cada una se encuesta a todo el personal. La capital queda así sobrerrepresentada, y además los empleados de una misma sucursal tienden a responder de manera parecida.
Con frecuencia, la base resultante se analiza como si fuera una muestra aleatoria simple: un porcentaje sin ponderar y un margen de error de manual. Este caso muestra cuánto puede equivocarse ese atajo, tanto en el valor estimado como en la incertidumbre que se le atribuye.
Ver código
import numpy as npimport pandas as pdimport matplotlib.pyplot as pltrng = np.random.default_rng(1984)# Población simulada: 60 sucursales en dos regionessucursales = pd.DataFrame({"sucursal": range(1, 61),"region": ["Interior"] *45+ ["Capital"] *15,})sucursales["empleados"] = rng.integers(12, 40, 60)# Clima de cada sucursal: el interior está, en promedio, menos satisfechobase = np.where(sucursales.region =="Interior", -0.35, 0.55)sucursales["efecto_sucursal"] = base + rng.normal(0, 0.75, 60)personas = sucursales.loc[sucursales.index.repeat(sucursales.empleados)].reset_index(drop=True)prob =1/ (1+ np.exp(-(personas.efecto_sucursal + rng.normal(0, 0.8, len(personas)))))personas["satisfecho"] = rng.binomial(1, prob)verdad = personas.satisfecho.mean()# Diseño: selección aleatoria de sucursales dentro de cada región, censo dentro de la sucursalmuestra_suc = {"Interior": 8, "Capital": 6}N_suc = sucursales.region.value_counts().to_dict()elegidas = pd.concat([ sucursales[sucursales.region == r].sample(n, random_state=11) for r, n in muestra_suc.items()])muestra = personas[personas.sucursal.isin(elegidas.sucursal)].copy()muestra["peso"] = muestra.region.map(lambda r: N_suc[r] / muestra_suc[r])muestra.groupby("region").agg(sucursales=("sucursal", "nunique"), personas=("satisfecho", "size"), peso=("peso", "first"), satisfechos=("satisfecho", "mean")).round(3)
sucursales
personas
peso
satisfechos
region
Capital
6
147
2.500
0.66
Interior
8
182
5.625
0.39
Cada persona encuestada del interior representa a 5,62 personas, mientras que cada una de la capital representa a 2,5. Ignorar esa diferencia equivale a darle a la capital más voz de la que tiene en la empresa.
Estimación ingenua y estimación según el diseño
La proporción ponderada es un estimador de razón, \(\hat p = \sum_i w_i y_i / \sum_i w_i\). Su varianza se aproxima por linealización, agregando las variables linealizadas \(z_i = w_i (y_i - \hat p)/\sum_i w_i\) por sucursal, que constituye la unidad primaria de muestreo, y midiendo su variabilidad dentro de cada región:
Un detalle que suele omitirse: con solo 14 sucursales en la muestra, los grados de libertad del diseño no son los 329 casos sino 14 − 2 = 12, de modo que el intervalo se construye con la distribución t de Student y no con el valor 1,96.
Dos diferencias saltan a la vista. La primera está en la estimación misma: el promedio simple sobrestima la satisfacción en unos 5 puntos porcentuales, porque da a la capital, más satisfecha, un peso que no tiene en la empresa. La segunda está en la incertidumbre: el efecto de diseño de esta muestra es de 1,5, lo que significa que las 329 entrevistas aportan tanta información como unas 216 entrevistas obtenidas por muestreo aleatorio simple. Los empleados de una misma sucursal se parecen entre sí, y cada respuesta adicional dentro de la sucursal agrega menos información nueva.
¿Qué método acierta?
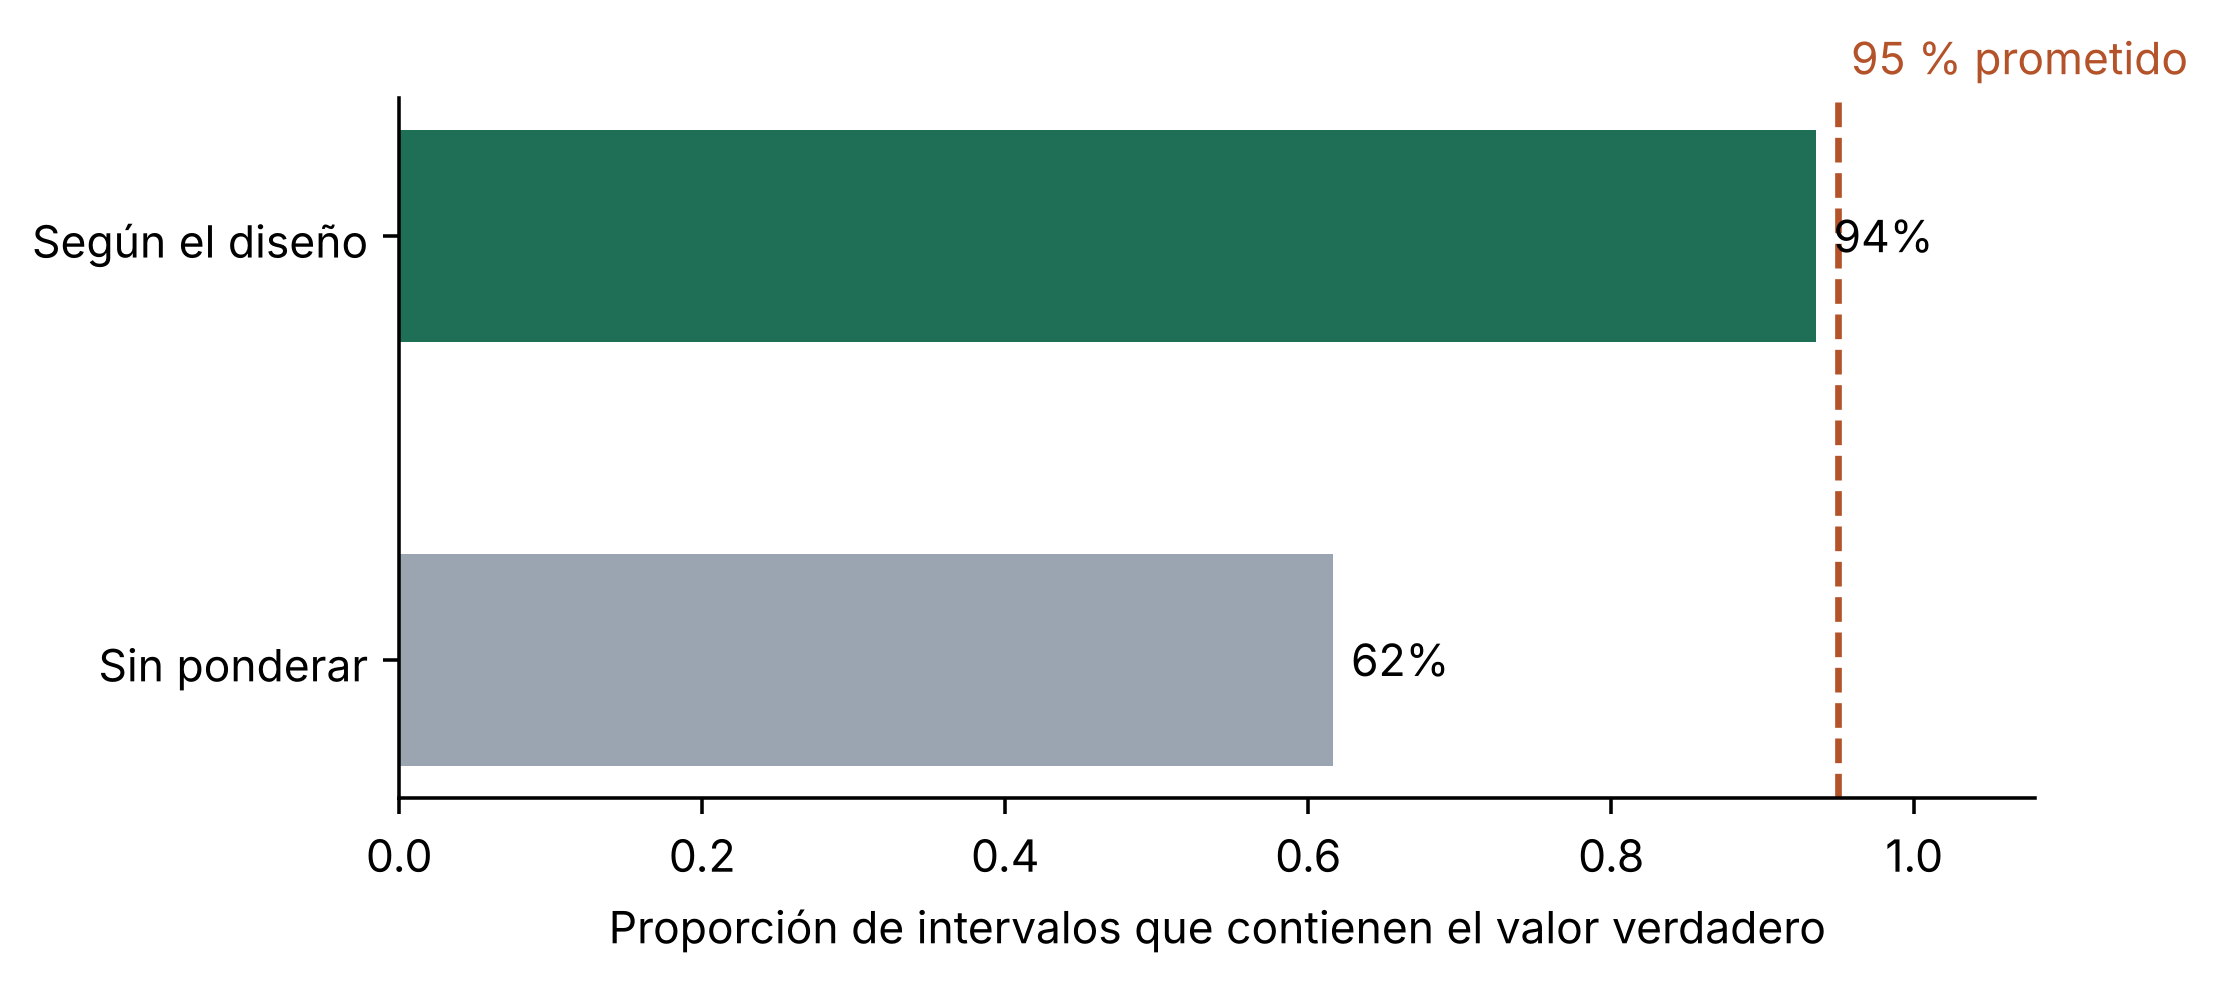
Una sola muestra no alcanza para juzgar un método. Por eso se repite el procedimiento completo en 2.000 muestras y se cuenta con qué frecuencia cada intervalo de confianza del 95 % contiene la verdadera proporción de empleados satisfechos.
Ver código
cobertura = {"Sin ponderar": 0, "Según el diseño": 0}efectos = []R =2000for r inrange(R): sel = pd.concat([ sucursales[sucursales.region == reg].sample(n, random_state=r *7+ i)for i, (reg, n) inenumerate(muestra_suc.items()) ]) m = personas[personas.sucursal.isin(sel.sucursal)].copy() m["peso"] = m.region.map(lambda reg: N_suc[reg] / muestra_suc[reg]) p1, ee1 = proporcion_ingenua(m) p2, ee2 = proporcion_diseno(m) cobertura["Sin ponderar"] +=abs(p1 - verdad) <=1.96* ee1 cobertura["Según el diseño"] +=abs(p2 - verdad) <= t_diseno * ee2 efectos.append((ee2 / ee1) **2)cob = pd.Series(cobertura) / Rfig, ax = plt.subplots(figsize=(7, 3.2))barras = ax.barh(cob.index, cob.values, color=["#9aa5b1", "#1f6f57"], height=0.5)ax.axvline(0.95, color="#b4532a", linestyle="--", linewidth=1.5)ax.text(0.95, 1.42, " 95 % prometido", color="#b4532a", va="center")ax.bar_label(barras, labels=[f"{v:.0%}"for v in cob.values], padding=4)ax.set_xlim(0, 1.08)ax.set_xlabel("Proporción de intervalos que contienen el valor verdadero")ax.spines[["top", "right"]].set_visible(False)plt.tight_layout()plt.show()
Figura 1: Cobertura real de los intervalos de confianza nominales del 95 % en 2.000 repeticiones del diseño.
El intervalo ingenuo promete un 95 % de confianza y acierta solo en el 62 % de las muestras: combina un sesgo, porque sobrerrepresenta a la capital, con un error estándar demasiado optimista. A lo largo de las repeticiones, el efecto de diseño promedio ronda 2,3. El intervalo que respeta el diseño alcanza una cobertura del 94 %, muy próxima a la nominal; la pequeña diferencia restante proviene de trabajar con apenas 14 sucursales, y por eso en estos casos conviene informar también cuántas unidades primarias sostienen cada estimación.
Qué recibe el cliente
Estimaciones ponderadas con márgenes de error honestos, también para subgrupos como regiones, áreas o antigüedad.
Un tabulado que marca qué diferencias son estadísticamente significativas y cuáles no.
La advertencia explícita de cuándo un subgrupo tiene muy pocos casos o pocas sucursales para concluir algo.
El código, para repetir el análisis en la próxima medición con exactamente los mismos criterios.